PCC fC NCKH: 12 phân phối xác suất trong nghiên cứu y học: từ lý thuyết đến xử lý số liệu & công bố khoa học!
PCC NCKH – Thăng Long, 01/11/2026, Trong quá trình thực hiện và hướng dẫn nghiên cứu khoa học, chúng ta thấy một trong những khó khăn thường gặp của sinh viên Y khoa và các nhà nghiên cứu trẻ không chỉ nằm ở việc lựa chọn phép kiểm định thống kê, mà quan trọng hơn là chưa hiểu đầy đủ bản chất của dữ liệu và cơ sở khoa học đằng sau mỗi phương pháp phân tích. Từ hình ảnh trực quan “If Distributions Had Personalities”, sử dụng sự hỗ trợ của trí tuệ nhân tạo (AI) để xây dựng bài viết giới thiệu 12 phân phối xác suất thường gặp, kết hợp giải thích nguyên lý thống kê, ứng dụng trong xử lý số liệu và những ví dụ từ các nghiên cứu Y học đã công bố trên các tạp chí quốc tế như New England Journal of Medicine (NEJM). Bài viết được biên soạn với mong muốn giúp các nhóm sinh viên nghiên cứu khoa học tiếp cận thống kê Y sinh theo hướng dễ hiểu, có hệ thống và gắn với thực hành, thay vì chỉ ghi nhớ một cách máy móc rằng khi nào sử dụng t-test, Chi-square, ANOVA hay hồi quy logistic. Muốn nhấn mạnh rằng đây là tài liệu học tập được biên soạn với sự hỗ trợ của AI, mang tính chất tham khảo, không thay thế giáo trình chuyên ngành hoặc tư vấn của chuyên gia thống kê. Một số ví dụ được mô phỏng nhằm minh họa phương pháp; các công thức, kết quả và tài liệu trích dẫn cần được đối chiếu với nguồn gốc trước khi sử dụng trong nghiên cứu chính thức.
Hy vọng các bạn dành thời gian đọc, trao đổi và thử áp dụng những kiến thức này vào chính bộ số liệu của nhóm mình. Điều quan trọng không phải là thuộc lòng 12 phân phối xác suất, mà là từng bước hình thành tư duy khoa học: Hiểu dữ liệu của mình là gì, tại sao lựa chọn phương pháp phân tích đó và kết quả thực sự có ý nghĩa như thế nào đối với người bệnh.
🌱 Một bài báo khoa học tốt không bắt đầu từ việc tìm kiếm p < 0,05, mà bắt đầu từ câu hỏi nghiên cứu đúng, dữ liệu đáng tin cậy, phương pháp phân tích phù hợp và sự trung thực trong diễn giải kết quả.
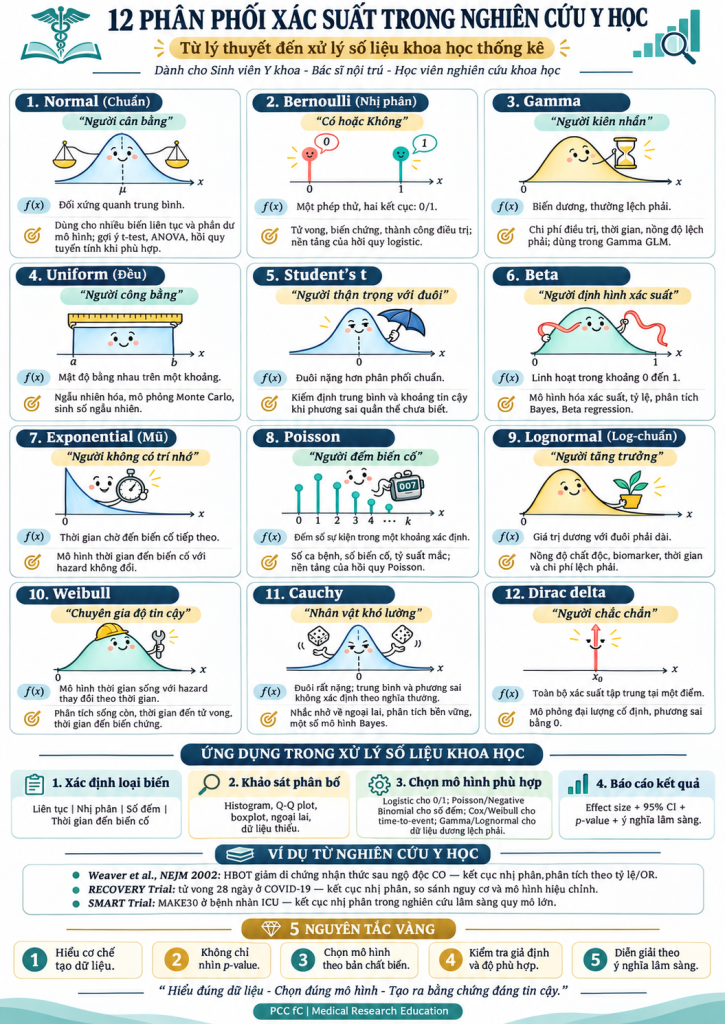
12 PHÂN PHỐI XÁC SUẤT TRONG NGHIÊN CỨU Y HỌC: TỪ LÝ THUYẾT ĐẾN XỬ LÝ SỐ LIỆU VÀ CÔNG BỐ KHOA HỌC
12 Probability Distributions in Medical Research: From Theory to Statistical Analysis and Scientific Publication
Chuyên đề: Thống kê Y sinh – Phương pháp nghiên cứu khoa học – Y học dựa trên bằng chứng
Đối tượng: Sinh viên Y khoa, bác sĩ nội trú, học viên cao học, bác sĩ lâm sàng và nhà nghiên cứu.
Định hướng: Thống kê ứng dụng trong nghiên cứu lâm sàng, đặc biệt tại các chuyên ngành Hồi sức cấp cứu, Chống độc, Nội khoa và Y học dự phòng.
I. TẠI SAO BÁC SĨ NGHIÊN CỨU KHOA HỌC CẦN HIỂU PHÂN PHỐI XÁC SUẤT?
Trong nghiên cứu Y học, chúng ta thường bắt đầu bằng việc thu thập dữ liệu: tuổi, giới tính, huyết áp, nồng độ lactate, creatinine, thời gian nằm viện, số biến chứng và tình trạng tử vong.
Tuy nhiên, không phải tất cả dữ liệu đều có bản chất thống kê giống nhau.
Hãy hình dung một nghiên cứu gồm 200 bệnh nhân ngộ độc cấp với sáu biến kết cục:
- Nồng độ natri máu, có thể phân bố tương đối đối xứng.
- Nồng độ chất độc trong huyết tương, thường lệch phải.
- Tử vong trong viện, chỉ nhận hai giá trị có hoặc không.
- Số cơn co giật, nhận các giá trị nguyên không âm.
- Thời gian đến tử vong, có thể có dữ liệu bị kiểm duyệt.
- Xác suất tử vong thực sự của quần thể, là tham số chưa biết cần ước lượng.
Nếu sử dụng cùng một phương pháp phân tích cho cả sáu biến, kết quả rất dễ sai lệch.
Nguyên tắc quan trọng là:
The statistical model must reflect the nature of the data, not merely the preference of the researcher.
Mô hình thống kê phải phản ánh bản chất dữ liệu, không đơn thuần phản ánh sở thích lựa chọn phép kiểm định của nhà nghiên cứu.
1. Phân phối xác suất là gì?
Phân phối xác suất mô tả những giá trị mà một biến ngẫu nhiên có thể nhận và xác suất xuất hiện của chúng.
Có hai nhóm cơ bản:
- Discrete distributions – Phân phối rời rạc: Bernoulli, Binomial, Poisson.
- Continuous distributions – Phân phối liên tục: Normal, Gamma, Uniform, Student’s t, Beta, Exponential, Lognormal, Weibull, Cauchy.
Delta Dirac là trường hợp đặc biệt mô tả khối lượng xác suất tập trung tại một điểm.
Với biến rời rạc, chúng ta sử dụng hàm khối xác suất, viết tắt PMF.
Với biến liên tục, chúng ta sử dụng hàm mật độ xác suất, viết tắt PDF.
Một điểm rất quan trọng: đối với biến liên tục, xác suất của một khoảng bằng diện tích dưới đường cong mật độ trên khoảng đó, không phải giá trị chiều cao của đường cong.
2. Phân biệt ba tầng thống kê
Sinh viên cần phân biệt:
Tầng 1 – Phân phối của dữ liệu: Ví dụ nồng độ chất độc có thể gần Lognormal.
Tầng 2 – Phân phối của thống kê mẫu: Ví dụ trung bình mẫu có thể gần phân phối chuẩn trong những điều kiện thích hợp.
Tầng 3 – Phân phối giả định của mô hình: Ví dụ trong hồi quy logistic, biến kết cục có phân phối Bernoulli có điều kiện theo các biến giải thích.
Ba tầng này có liên quan nhưng không đồng nhất.
Một sai lầm thường gặp là thấy dữ liệu gốc không chuẩn rồi kết luận rằng không được sử dụng bất kỳ phương pháp hồi quy tuyến tính nào. Trên thực tế, cần kiểm tra cấu trúc phần dư, phương sai, tính độc lập và mục tiêu suy luận của mô hình.
II. 12 PHÂN PHỐI XÁC SUẤT VÀ ỨNG DỤNG TRONG Y HỌC
1. NORMAL DISTRIBUTION – PHÂN PHỐI CHUẨN
Biệt danh: The Balanced One – Người cân bằng.
1.1. Bản chất
Phân phối chuẩn có dạng hình chuông, đối xứng quanh trung bình μ.
Công thức:
f(x) = [1/(σ√2π)] × exp[-(x−μ)²/(2σ²)]
Trong đó:
- μ: trung bình quần thể.
- σ: độ lệch chuẩn quần thể.
- σ²: phương sai.
Các đặc tính:
- Mean = Median = Mode.
- Khoảng μ ± 1SD chứa khoảng 68,3% xác suất.
- Khoảng μ ± 2SD chứa khoảng 95,4%.
- Khoảng μ ± 3SD chứa khoảng 99,7%.
Minh họa 1 – Phân phối chuẩn
Mật độ
              /\
             /  \
           /      \
         /          \
_______/              \_______
        μ−σ   μ   μ+σ

     Đối xứng quanh μ
1.2. Ví dụ số liệu Y học
Giả sử một quần thể có nồng độ natri máu phân phối chuẩn với μ = 140 mmol/L và σ = 4 mmol/L.
Một bệnh nhân có natri 132 mmol/L.
Điểm chuẩn hóa:
Z = (132−140)/4 = −2.
Như vậy giá trị này thấp hơn trung bình quần thể hai độ lệch chuẩn.
Theo mô hình chuẩn, khoảng 2,28% quần thể có giá trị thấp hơn hoặc bằng mức này.
Đây là ví dụ minh họa toán học, không phải căn cứ duy nhất để chẩn đoán hạ natri máu.
1.3. Ứng dụng xử lý số liệu
Giả sử nghiên cứu so sánh huyết áp tâm thu ở hai nhóm bệnh nhân.
Nhóm A: n = 50, mean = 125 mmHg, SD = 15.
Nhóm B: n = 50, mean = 135 mmHg, SD = 18.
Chênh lệch trung bình:
Mean difference = 125−135 = −10 mmHg.
Sai số chuẩn của chênh lệch:
SE = √(15²/50 + 18²/50) ≈ 3,31.
Thống kê Welch t:
t ≈ −10/3,31 = −3,02.
Khi các giả định phù hợp, có thể sử dụng Welch’s t-test để đánh giá khác biệt giữa hai trung bình.
Báo cáo khoa học phù hợp:
Mean difference −10,0 mmHg; 95% CI xấp xỉ −16,6 đến −3,4 mmHg.
Đây là phép tính minh họa, không phải kết quả từ một thử nghiệm đã công bố.
1.4. Các phương pháp liên quan
- One-sample t-test.
- Independent-samples t-test.
- Paired t-test.
- Welch’s t-test.
- ANOVA.
- Linear regression.
Cần chú ý: t-test không đồng nghĩa với yêu cầu mọi biến trong bộ dữ liệu phải phân phối chuẩn. Giả định cụ thể phụ thuộc mô hình, sự độc lập, kích thước mẫu và mức độ ngoại lai.
2. BERNOULLI DISTRIBUTION – PHÂN PHỐI NHỊ PHÂN
Biệt danh: The Yes-or-No One – Người có hoặc không.
2.1. Bản chất
Biến Bernoulli chỉ nhận hai giá trị:
X = 1 nếu xảy ra biến cố.
X = 0 nếu không xảy ra biến cố.
P(X=1) = p.
P(X=0) = 1−p.
Kỳ vọng E(X) = p.
Phương sai Var(X) = p(1−p).
Minh họa 2 – Kết cục nhị phân
Bệnh nhân sau điều trị
          |
     +----+----+
     |         |
  Sống (0)  Tử vong (1)
     |         |
    1−p        p
2.2. Ví dụ từ nghiên cứu thật: Weaver và cộng sự, NEJM 2002
Nghiên cứu ngẫu nhiên có đối chứng đánh giá liệu pháp oxy cao áp đối với di chứng nhận thức sau ngộ độc carbon monoxide.
Số bệnh nhân: 152.
Mỗi nhóm: 76 bệnh nhân.
Kết cục chính: có hoặc không có di chứng nhận thức tại 6 tuần.
Kết quả:
| Nhóm điều trị | Có di chứng | Không di chứng | Tổng |
|---|---|---|---|
| HBOT | 19 | 57 | 76 |
| Nhóm so sánh | 35 | 41 | 76 |
Tỷ lệ di chứng:
HBOT = 19/76 = 25,0%.
Nhóm so sánh = 35/76 = 46,1%.
Minh họa 3 – Tỷ lệ di chứng nhận thức
HBOT          ██████████           25,0%

Nhóm so sánh  ██████████████████   46,1%

Mỗi khối đại diện xấp xỉ 2,5 điểm %
2.3. Tính các thước đo hiệu quả
Absolute Risk Reduction – ARR
ARR = 46,1%−25,0% = 21,1 điểm phần trăm.
Ý nghĩa: nguy cơ di chứng nhận thức thấp hơn 21,1 điểm phần trăm trong nhóm HBOT.
Relative Risk – RR
RR = (19/76)/(35/76) = 19/35 ≈ 0,543.
Diễn giải: nguy cơ di chứng trong nhóm HBOT bằng khoảng 54,3% nguy cơ của nhóm so sánh.
Relative Risk Reduction – RRR
RRR = 1−RR ≈ 45,7%.
Odds Ratio – OR
OR = (19×41)/(57×35) ≈ 0,390.
Kết quả nghiên cứu công bố OR chưa hiệu chỉnh khoảng 0,39 và OR hiệu chỉnh là 0,45, với 95% CI 0,22–0,92.
Number Needed to Treat – NNT
NNT = 1/ARR = 1/0,2105 ≈ 4,75.
Làm tròn lên: NNT = 5.
Có thể hiểu theo ước lượng điểm từ nghiên cứu: cần điều trị khoảng 5 bệnh nhân để tránh thêm một trường hợp di chứng nhận thức tại 6 tuần, so với phác đồ đối chứng của thử nghiệm.
Kết quả này không nên tự động khái quát cho tất cả bệnh nhân ngộ độc CO hoặc mọi phác đồ HBOT.
Nguồn: Weaver LK và cộng sự. Hyperbaric Oxygen for Acute Carbon Monoxide Poisoning. New England Journal of Medicine. 2002;347:1057–1067. DOI: 10.1056/NEJMoa013121.
2.4. Chọn phương pháp thống kê
Đối với kết cục nhị phân:
- Chi-square test: so sánh tỷ lệ khi điều kiện xấp xỉ phù hợp.
- Fisher’s exact test: hữu ích với bảng nhỏ hoặc số lượng kỳ vọng thấp.
- Logistic regression: phân tích liên quan sau hiệu chỉnh biến giải thích.
- Modified Poisson regression với robust variance: lựa chọn để ước lượng risk ratio trong nhiều nghiên cứu đoàn hệ.
- Binomial regression với log link: trực tiếp mô hình hóa risk ratio khi mô hình hội tụ.
Công thức logistic:
log[p/(1−p)] = β₀ + β₁X₁ + β₂X₂ + …
Khi đó exp(β₁) là odds ratio có điều kiện theo các biến còn lại.
Lưu ý: Logistic regression ước lượng OR, không trực tiếp ước lượng RR. Hai đại lượng có thể khác nhau đáng kể khi biến cố thường gặp.
3. GAMMA DISTRIBUTION – PHÂN PHỐI GAMMA
Biệt danh: The Patient One – Người kiên nhẫn.
3.1. Bản chất
Gamma là phân phối liên tục trên các giá trị dương.
Thường được sử dụng khi dữ liệu:
- Không âm và thực tế lớn hơn 0.
- Lệch phải.
- Có phương sai tăng theo bình phương trung bình, trong mô hình Gamma GLM với tham số phân tán không đổi.
Với tham số shape α và rate β:
E(X) = α/β.
Var(X) = α/β².
3.2. Ví dụ giả định: chi phí điều trị ngộ độc cấp
Một nghiên cứu gồm 150 bệnh nhân có chi phí điều trị như sau:
- Trung bình: 30 triệu đồng.
- Trung vị: 18 triệu đồng.
- Một số bệnh nhân cần ECMO hoặc lọc máu liên tục có chi phí trên 100 triệu đồng.
Phân phối có thể lệch phải rõ rệt.
Minh họa 4 – Chi phí điều trị
Số bệnh nhân
████████████████   0–20 triệu
██████████         20–40 triệu
█████              40–60 triệu
██                 60–80 triệu
█                  >80 triệu
3.3. Phân tích bằng Gamma GLM
Mục tiêu: đánh giá liệu lọc máu liên tục có liên quan đến chi phí điều trị cao hơn hay không, sau khi hiệu chỉnh tuổi, SOFA và mức độ bệnh.
Mô hình:
log[E(Cost|X)] = β₀ + β₁(CVVH) + β₂(SOFA) + β₃(Age).
Giả sử hệ số β₁ = 0,40.
Khi đó:
exp(0,40) ≈ 1,49.
Diễn giải: trong mô hình này, chi phí trung bình kỳ vọng ở nhóm CVVH cao gấp khoảng 1,49 lần nhóm không CVVH, sau khi giữ cố định các biến hiệu chỉnh.
Đây là mối liên quan đã hiệu chỉnh, không nhất thiết là tác động nhân quả của CVVH đối với chi phí.
3.4. Khi nào không nên dùng Gamma?
- Có nhiều giá trị chi phí bằng 0.
- Kết cục có phân phối đa đỉnh mà mô hình không mô tả được.
- Hàm phương sai giả định không phù hợp.
- Phần dư và quan sát có ảnh hưởng lớn cho thấy mô hình không ổn định.
Có thể cân nhắc mô hình hai phần nếu có tỷ lệ lớn giá trị bằng 0.
4. UNIFORM DISTRIBUTION – PHÂN PHỐI ĐỀU
Biệt danh: The Fair One – Người công bằng.
4.1. Bản chất
Với X phân phối đều trên [a,b]:
f(x) = 1/(b−a).
Mỗi khoảng có độ dài bằng nhau có xác suất bằng nhau.
Cần phân biệt điều này với phát biểu sai rằng mỗi số thực riêng lẻ trong khoảng có xác suất dương bằng nhau. Đối với Uniform liên tục, xác suất tại từng điểm riêng lẻ bằng 0.
4.2. Ứng dụng trong nghiên cứu ngẫu nhiên
Giả sử thử nghiệm lâm sàng so sánh hai phác đồ điều trị ngộ độc.
Máy tính tạo U phân phối Uniform(0,1).
Quy tắc:
- Nếu U < 0,5: nhóm A.
- Nếu U ≥ 0,5: nhóm B.
Đây là cơ sở của ngẫu nhiên hóa đơn giản 1:1.
Tuy nhiên, nghiên cứu thực tế còn cần che giấu phân bổ, quản lý danh sách ngẫu nhiên và có thể sử dụng block randomization hoặc stratified randomization.
4.3. Ứng dụng trong mô phỏng Monte Carlo
Giả sử ta muốn khảo sát độ bất định của một tham số chưa biết nhưng tạm giả định nằm trong khoảng 0,1–0,3, với phân phối Uniform.
Ta có thể sinh 10.000 giá trị ngẫu nhiên từ Uniform(0,1), sau đó biến đổi:
p = 0,1 + 0,2U.
Kết quả mô phỏng giúp khảo sát ảnh hưởng của các giá trị p khác nhau đến đầu ra mô hình.
Lưu ý: gán Uniform cho một tham số có nghĩa là đưa ra giả định cụ thể về độ bất định. Không nên dùng chỉ vì chưa biết nên chọn phân phối nào.
5. STUDENT’S t DISTRIBUTION – PHÂN PHỐI t-STUDENT
Biệt danh: The Tail-Risk Realist – Người thận trọng với rủi ro ở đuôi.
5.1. Bản chất
Phân phối t tương tự phân phối chuẩn nhưng có đuôi nặng hơn khi bậc tự do nhỏ.
Đối với một mẫu độc lập lấy từ quần thể chuẩn, dưới giả thuyết trung bình μ₀:
t = (x̄−μ₀)/(s/√n).
Thống kê này tuân theo phân phối t với n−1 bậc tự do.
Khi bậc tự do tăng, phân phối t tiến gần chuẩn.
5.2. Ví dụ thực hành
Một nghiên cứu đo nồng độ hemoglobin trước và sau can thiệp ở 20 bệnh nhân.
Giả sử:
- Trung bình chênh lệch sau trừ trước: +1,2 g/dL.
- SD của chênh lệch: 1,8 g/dL.
- n = 20.
Sai số chuẩn:
SE = 1,8/√20 ≈ 0,402.
Thống kê kiểm định:
t = 1,2/0,402 ≈ 2,98.
Bậc tự do = 19.
Khoảng tin cậy 95% xấp xỉ:
1,2 ± 2,093×0,402.
Tương ứng khoảng 0,36–2,04 g/dL.
5.3. Chọn kiểm định ghép cặp
Vì hai lần đo thuộc cùng một bệnh nhân nên các quan sát không độc lập giữa hai thời điểm.
Phương pháp phù hợp trong tình huống này là paired t-test nếu giả định về phân phối chênh lệch và các điều kiện khác được đáp ứng.
Không được dùng independent t-test chỉ vì có hai cột số liệu.
Nếu chênh lệch rất lệch hoặc xuất hiện ngoại lai lớn, có thể cân nhắc phương pháp khác như Wilcoxon signed-rank, bootstrap phù hợp hoặc mô hình vững. Wilcoxon cũng có các giả định riêng.
5.4. Một phân biệt cần ghi nhớ
Phân phối Student’s t trong kiểm định trung bình không có nghĩa rằng dữ liệu sinh học gốc phải tuân theo phân phối t.
Đây chủ yếu là phân phối tham chiếu của thống kê kiểm định dưới những giả định xác định.
6. BETA DISTRIBUTION – PHÂN PHỐI BETA
Biệt danh: The Probability Shaper – Người định hình xác suất.
6.1. Bản chất
Beta được xác định trên khoảng từ 0 đến 1.
E(p) = α/(α+β).
Var(p) = αβ/[(α+β)²(α+β+1)].
Thay đổi α và β sẽ tạo những hình dạng khác nhau.
6.2. Ví dụ: ước lượng xác suất tử vong trong ngộ độc cấp
Giả sử một nghiên cứu ghi nhận:
- 100 bệnh nhân.
- 20 tử vong.
- 80 sống.
Tỷ lệ tử vong quan sát là 20%.
Trong phân tích Bayes, giả định phân phối tiên nghiệm cho xác suất tử vong p là Beta(1,1).
Với mô hình Bernoulli độc lập có cùng xác suất p, phân phối hậu nghiệm là:
p | data ~ Beta(21,81).
Trung bình hậu nghiệm:
E(p|data) = 21/102 ≈ 20,6%.
Có thể tính khoảng tin cậy Bayes (credible interval) 95% từ các phân vị 2,5% và 97,5% của phân phối Beta(21,81).
6.3. Ứng dụng
- Ước lượng xác suất biến cố theo Bayes.
- Mô hình Beta–Binomial.
- Mô hình hóa xác suất nhạy cảm, độ đặc hiệu trong các cấu trúc Bayes thích hợp.
- Beta regression đối với tỷ lệ liên tục nằm giữa 0 và 1.
Không nên tự động dùng hồi quy Beta để phân tích biến số nhị phân ở mức từng bệnh nhân. Đối với dữ liệu 0/1, Bernoulli và logistic thường là lựa chọn tự nhiên hơn.
7. EXPONENTIAL DISTRIBUTION – PHÂN PHỐI MŨ
Biệt danh: The Memoryless One – Người không có trí nhớ.
7.1. Bản chất
Phân phối mũ mô tả thời gian đến biến cố tiếp theo trong mô hình có tốc độ xuất hiện biến cố không đổi.
f(t) = λexp(−λt), với t ≥ 0.
Hàm sống còn:
S(t) = exp(−λt).
Hàm nguy cơ:
h(t) = λ.
Đặc tính nổi bật là hazard không đổi theo thời gian.
7.2. Ví dụ: thời gian đến cuộc gọi tiếp theo
Giả sử các cuộc gọi đến Trung tâm Chống độc xuất hiện theo quá trình Poisson thuần nhất với trung bình 3 cuộc gọi mỗi giờ.
Khi đó thời gian giữa hai cuộc gọi liên tiếp có phân phối mũ với λ = 3/giờ.
Xác suất không có cuộc gọi mới trong 30 phút:
P(T>0,5) = exp(−3×0,5) ≈ 0,223.
Tức khoảng 22,3%.
7.3. Ứng dụng phân tích sống còn
Nếu thời gian đến biến cố được mô tả hợp lý bằng phân phối mũ, có thể xây dựng mô hình sống còn tham số.
Tuy nhiên, nguy cơ tử vong của bệnh nhân ICU thường thay đổi theo thời gian và tình trạng bệnh. Vì vậy, giả định hazard không đổi phải được đánh giá chứ không được mặc định.
8. POISSON DISTRIBUTION – PHÂN PHỐI POISSON
Biệt danh: The Counter – Người đếm biến cố.
8.1. Bản chất
Poisson mô tả số biến cố trong một đơn vị thời gian hoặc không gian.
P(X=k) = exp(−λ)λᵏ/k!.
Ở phân phối Poisson lý tưởng:
Mean = Variance = λ.
8.2. Ví dụ: số ca ngộ độc CO mỗi tháng
Giả sử số ca ngộ độc CO trung bình là 6 ca/tháng.
Xác suất có đúng 4 ca trong một tháng:
P(X=4) = exp(−6)×6⁴/4! ≈ 0,134.
Tức khoảng 13,4%.
8.3. Hồi quy Poisson trong nghiên cứu bệnh viện
Giả sử muốn phân tích số ca nhiễm khuẩn bệnh viện theo tổng số ngày điều trị.
Biến kết cục: số lần nhiễm khuẩn.
Biến giải thích: can thiệp, thời gian, đặc điểm bệnh nhân.
Mô hình:
log[E(Y|X,T)] = β₀ + β₁X + log(T).
Trong đó log(T) là offset, thể hiện người-thời gian phơi nhiễm.
Giả sử:
- Giai đoạn A: 12 biến cố/1.000 ngày điều trị.
- Giai đoạn B: 8 biến cố/1.000 ngày điều trị.
Incidence rate ratio:
IRR = 8/12 ≈ 0,67.
Nếu các số liệu này đến từ hai nhóm có thời gian theo dõi và các đặc điểm khác nhau, hồi quy Poisson có offset và hiệu chỉnh yếu tố nhiễu có thể phù hợp hơn so sánh số ca thô.
8.4. Overdispersion – Hiện tượng quá phân tán
Nếu phương sai lớn hơn giá trị trung bình đáng kể, dữ liệu có thể không đáp ứng giả định Poisson.
Ví dụ:
Mean = 4 biến cố.
Variance = 15.
Mô hình Negative Binomial có thể phù hợp hơn vì cho phép phương sai lớn hơn trung bình.
Những nguyên nhân khác như zero inflation, phân cụm và thời gian phơi nhiễm không đồng nhất cũng cần được xem xét.
9. LOGNORMAL DISTRIBUTION – PHÂN PHỐI LOG-CHUẨN
Biệt danh: The Growth Seeker – Người hướng tới tăng trưởng.
9.1. Bản chất
Một biến X có phân phối lognormal nếu:
ln(X) ~ Normal(μ,σ²).
Lognormal có ba đặc điểm:
- Giá trị dương.
- Phân phối thường lệch phải.
- Trung bình lớn hơn trung vị.
9.2. Ví dụ từ bài báo phương pháp thống kê trên BMJ
Bland và Altman, trong bài Transformations, means, and confidence intervals đăng trên BMJ năm 1996, đã sử dụng dữ liệu triglyceride huyết thanh để giải thích biến đổi log.
Dữ liệu gốc có phân phối lệch phải.
Bài báo trình bày:
- Trung bình số học: 0,51 mmol/L.
- SD: 0,22 mmol/L.
- Trung bình nhân: khoảng 0,47 mmol/L.
- Khoảng tin cậy 95% cho trung bình nhân: khoảng 0,45–0,49 mmol/L.
Ví dụ cho thấy biến đổi log có thể giúp phân tích dữ liệu sinh học lệch phải và tạo ra kết quả được diễn giải dưới dạng trung bình nhân hoặc tỷ số trung bình nhân.
Nguồn: Bland JM, Altman DG. Statistics notes: Transformations, means, and confidence intervals. BMJ. 1996;312:1079. DOI: 10.1136/bmj.312.7038.1079.
9.3. Áp dụng với nồng độ chất độc
Giả sử nồng độ chất độc của 100 bệnh nhân trải từ 0,5 đến 500 mg/L.
Một số giá trị rất cao làm kéo dài đuôi phải.
Nếu nghiên cứu sử dụng hồi quy:
ln(Concentration) = β₀ + β₁X + ε.
Giả sử β₁ = 0,30.
exp(0,30) ≈ 1,35.
Trong điều kiện mô hình thích hợp, biến X liên quan đến mức trung bình nhân nồng độ cao hơn khoảng 35%.
Lưu ý quan trọng: hồi quy log của biến kết cục và hồi quy Gamma log link đều có hệ số diễn giải trên thang tỷ số, nhưng đại lượng trung bình được mô hình hóa không giống nhau.
10. WEIBULL DISTRIBUTION – PHÂN PHỐI WEIBULL
Biệt danh: The Reliability Expert – Chuyên gia độ tin cậy.
10.1. Bản chất
Weibull thường được sử dụng trong phân tích thời gian đến biến cố.
Hàm sống còn:
S(t) = exp[−(t/λ)ᵏ].
Hàm nguy cơ:
h(t) = (k/λ)(t/λ)^(k−1).
Trong đó:
- k: shape parameter.
- λ: scale parameter.
10.2. Ba hình thái hazard
k < 1: hazard giảm theo thời gian.
k = 1: hazard không đổi, tương đương mô hình mũ.
k > 1: hazard tăng theo thời gian.
10.3. Ví dụ: thời gian đến tử vong ở bệnh nhân ngộ độc nặng
Giả sử nghiên cứu 300 bệnh nhân theo dõi trong 30 ngày.
Một số tử vong trong thời gian theo dõi.
Những bệnh nhân còn sống tại ngày 30 được kiểm duyệt hành chính.
Mục tiêu là nghiên cứu thời gian đến tử vong.
Nếu hazard có cấu trúc phù hợp, mô hình Weibull có thể được sử dụng để ước lượng hàm sống còn và mối liên quan với các yếu tố tiên lượng.
10.4. So sánh với Kaplan–Meier và Cox
Kaplan–Meier: ước lượng không tham số hàm sống còn.
Cox proportional hazards: mô hình bán tham số, không cần xác định hình dạng hazard nền, nhưng cần xem xét giả định proportional hazards.
Weibull: mô hình tham số, giả định một cấu trúc cụ thể của hazard.
Không có một phương pháp tốt nhất cho mọi bộ dữ liệu.
11. CAUCHY DISTRIBUTION – PHÂN PHỐI CAUCHY
Biệt danh: The Wild Card – Nhân vật khó lường.
11.1. Bản chất
Cauchy có đuôi rất nặng.
Đặc biệt:
- Kỳ vọng thông thường không tồn tại.
- Phương sai không tồn tại.
- Trung bình mẫu không ổn định theo cách của dữ liệu có kỳ vọng hữu hạn.
11.2. Ý nghĩa đối với nghiên cứu Y học
Phân phối Cauchy cho thấy một bài học quan trọng: không phải lúc nào lấy trung bình nhiều quan sát cũng làm ước lượng ổn định.
Trong thực hành Y sinh, Cauchy không phải phân phối mặc định cho nồng độ xét nghiệm.
Tuy nhiên, nó có ứng dụng trong mô hình hóa đuôi nặng và phân tích Bayes, ví dụ các tiên nghiệm Cauchy hoặc half-Cauchy thích hợp.
11.3. Bài học về ngoại lai
Giả sử một bộ dữ liệu lactate có một giá trị cực đoan.
Trước khi loại bỏ, cần xác minh:
- Có phải sai số nhập liệu?
- Có phải lỗi thiết bị?
- Có sai đơn vị?
- Có phải giá trị sinh học thực sự?
- Kết quả phân tích nhạy cảm với giá trị này đến mức nào?
Không được loại ngoại lai chỉ nhằm làm p-value trở nên có ý nghĩa thống kê.
12. DIRAC DELTA – PHÂN PHỐI SUY BIẾN TẠI MỘT ĐIỂM
Biệt danh: The Certain One – Người chắc chắn.
12.1. Bản chất
Toàn bộ khối lượng xác suất nằm tại một giá trị x₀.
P(X=x₀) = 1.
Phương sai bằng 0.
Delta Dirac là cách biểu diễn toán học của khối lượng xác suất tập trung ở một điểm, không phải một mật độ liên tục thông thường.
12.2. Ví dụ trong nghiên cứu Y học
Trong mô hình kinh tế y tế, nhà nghiên cứu có thể cố định một chi phí hoặc một hệ số bằng một giá trị xác định.
Trong phân tích độ nhạy, thay vì giữ giá trị cố định, có thể thay bằng phân phối xác suất phù hợp để phản ánh bất định.
Bài học: một tham số cố định trong mô hình không đồng nghĩa với việc nó hoàn toàn chắc chắn trong thế giới thực.
III. PHÂN PHỐI XÁC SUẤT LIÊN QUAN NHƯ THẾ NÀO ĐẾN CÁC KIỂM ĐỊNH THỐNG KÊ?
Một nhầm lẫn phổ biến là coi phân phối xác suất và phép kiểm định là hai khái niệm thay thế cho nhau.
Trên thực tế:
- Phân phối xác suất mô tả dữ liệu hoặc biến ngẫu nhiên.
- Phép kiểm định đánh giá một giả thuyết thống kê.
- Mô hình hồi quy mô tả mối liên hệ giữa biến kết cục và các biến giải thích.
- Khoảng tin cậy biểu thị độ chính xác của ước lượng theo quy trình suy luận được sử dụng.
1. Bảng lựa chọn phương pháp thực hành
| Câu hỏi nghiên cứu | Kiểu kết cục | Phương pháp ứng viên |
|---|---|---|
| So sánh trung bình hai nhóm độc lập | Liên tục | Welch’s t-test |
| So sánh trước – sau cùng bệnh nhân | Liên tục ghép cặp | Paired t-test |
| So sánh phân bố hai nhóm | Liên tục/thứ bậc | Mann–Whitney U |
| So sánh tỷ lệ tử vong | Nhị phân | Chi-square/Fisher; hồi quy |
| Tìm yếu tố liên quan tử vong | Nhị phân | Logistic regression |
| Phân tích tỷ lệ nguy cơ | Nhị phân | Log-binomial/modified Poisson |
| Phân tích số biến cố | Số đếm | Poisson/Negative Binomial |
| Phân tích chi phí | Liên tục dương | Gamma GLM/log models |
| Phân tích thời gian đến tử vong | Time-to-event | Kaplan–Meier/Cox/Weibull |
| Phân tích tỷ lệ liên tục (0,1) | Phân số liên tục | Beta regression |
| Phân tích đo lặp lại | Phụ thuộc trong bệnh nhân | Mixed-effects models/GEE |
Bảng này chỉ cung cấp phương án khởi đầu. Lựa chọn cuối cùng phải dựa trên thiết kế nghiên cứu, giả định, mục tiêu ước lượng và cấu trúc phụ thuộc.
2. Vì sao kiểm định Shapiro–Wilk không phải là tất cả?
Shapiro–Wilk được sử dụng để kiểm định giả thuyết dữ liệu tuân theo phân phối chuẩn.
Nhưng:
- Cỡ mẫu nhỏ có thể không đủ khả năng phát hiện lệch chuẩn đáng kể.
- Cỡ mẫu rất lớn có thể phát hiện sai khác nhỏ, ít quan trọng trong thực hành.
- Phân phối biến gốc không phải lúc nào cũng là giả định cần kiểm tra.
- Cần kết hợp histogram, Q–Q plot, boxplot, phần dư và kiến thức chuyên ngành.
Quy tắc: không nên quyết định toàn bộ chiến lược thống kê chỉ bằng một p-value của Shapiro–Wilk.
IV. BA VÍ DỤ THỰC TẾ TỪ CÁC BÀI BÁO NEJM
Ví dụ 1. Nghiên cứu Weaver 2002 – Oxy cao áp và di chứng nhận thức sau ngộ độc CO
Thiết kế: Randomized controlled trial.
Số bệnh nhân: 152.
Biến kết cục: di chứng nhận thức tại 6 tuần, dạng nhị phân.
Kết quả:
- HBOT: 25,0%.
- Nhóm đối chứng: 46,1%.
- OR chưa hiệu chỉnh: 0,39; 95% CI 0,20–0,78.
- OR hiệu chỉnh: 0,45; 95% CI 0,22–0,92.
Bài học thống kê:
Kết cục nhị phân dẫn đến các phép ước lượng tỷ lệ, RR, OR, ARR, NNT và mô hình logistic.
Nhà nghiên cứu cần biết lựa chọn thước đo nào phản ánh tốt nhất câu hỏi lâm sàng.
DOI: 10.1056/NEJMoa013121.
Ví dụ 2. RECOVERY Trial – Dexamethasone ở bệnh nhân COVID-19
Thiết kế: Randomized controlled trial.
Biến kết cục chính: tử vong trong 28 ngày.
Kết quả công bố:
| Nhóm | Tử vong | Tổng bệnh nhân | Tỷ lệ |
|---|---|---|---|
| Dexamethasone | 482 | 2.104 | 22,9% |
| Điều trị thông thường | 1.110 | 4.321 | 25,7% |
Nghiên cứu báo cáo age-adjusted rate ratio = 0,83; 95% CI 0,75–0,93.
Tỷ số nguy cơ thô tính từ hai tỷ lệ tích lũy xấp xỉ 0,89. Không được coi nó là cùng một đại lượng với rate ratio đã hiệu chỉnh trong bài báo.
Bài học:
Cùng một kết cục tử vong nhưng cách xác định thời gian, mô hình và hiệu chỉnh có thể dẫn đến những ước lượng khác nhau.
Ngoài ra, tác dụng điều trị thay đổi giữa các nhóm hỗ trợ hô hấp, nhắc nhở nhà nghiên cứu cần quan tâm đến dị biệt hiệu quả điều trị và cách phân tích phân nhóm.
Nguồn: RECOVERY Collaborative Group. Dexamethasone in Hospitalized Patients with Covid-19. NEJM. 2021;384:693–704. DOI: 10.1056/NEJMoa2021436.
Ví dụ 3. SMART Trial – Dịch tinh thể cân bằng và NaCl 0,9% ở bệnh nhân ICU
Thiết kế: Thử nghiệm ngẫu nhiên theo cụm, có chuyển đổi can thiệp nhiều giai đoạn.
Quy mô: 15.802 bệnh nhân.
Kết cục chính: Major adverse kidney events within 30 days – MAKE30.
Kết quả:
| Nhóm | Số biến cố | Tổng số | Tỷ lệ |
|---|---|---|---|
| Balanced crystalloids | 1.139 | 7.942 | 14,3% |
| Saline | 1.211 | 7.860 | 15,4% |
Nghiên cứu báo cáo marginal OR = 0,91; 95% CI 0,84–0,99.
Bài học thống kê:
MAKE30 là kết cục tổng hợp nhị phân: bệnh nhân có hoặc không có ít nhất một thành phần của kết cục.
Điều đặc biệt là nghiên cứu ngẫu nhiên theo cụm, vì vậy không nên phân tích như thể mọi bệnh nhân được phân bổ độc lập hoàn toàn.
Cấu trúc phân cụm và giai đoạn can thiệp cần được phản ánh trong phương pháp phân tích.
Nguồn: Semler MW và cộng sự. Balanced Crystalloids versus Saline in Critically Ill Adults. NEJM. 2018;378:829–839. DOI: 10.1056/NEJMoa1711584.
V. HƯỚNG DẪN XỬ LÝ SỐ LIỆU TỪ EXCEL ĐẾN BÀI BÁO
Bước 1. Thiết kế bộ dữ liệu chuẩn
Mỗi dòng nên đại diện cho một đơn vị quan sát xác định.
Trong nghiên cứu đơn giản, mỗi dòng là một bệnh nhân.
Ví dụ:
| ID | Age | Sex | SOFA | Lactate | CVVH | Death28 |
|---|---|---|---|---|---|---|
| 001 | 45 | 1 | 8 | 3,2 | 0 | 0 |
| 002 | 62 | 0 | 12 | 8,5 | 1 | 1 |
| 003 | 39 | 1 | 5 | 1,8 | 0 | 0 |
| 004 | 71 | 0 | 15 | 12,4 | 1 | 1 |
| 005 | 54 | 1 | 9 | 4,6 | 1 | 0 |
Dữ liệu bảng trên là minh họa, không phải số liệu nghiên cứu đã công bố.
Cần xây dựng data dictionary:
- Age: tuổi, năm.
- Sex: mã 0/1 theo định nghĩa trong đề cương.
- SOFA: điểm mức độ suy tạng.
- Lactate: mmol/L.
- CVVH: có hoặc không.
- Death28: tử vong trong 28 ngày.
Nếu một bệnh nhân có nhiều lần đo, cần định nghĩa thêm cấu trúc dữ liệu dọc, thời điểm đo và mã định danh để mô hình hóa tương quan trong bệnh nhân.
Bước 2. Làm sạch dữ liệu
Kiểm tra các vấn đề:
- Thiếu dữ liệu.
- Trùng mã bệnh nhân.
- Sai đơn vị đo.
- Giá trị ngoài phạm vi hợp lý.
- Biến phân loại mã hóa không thống nhất.
- Dữ liệu ngày giờ không hợp lệ.
- Các giá trị ngoại lai.
- Thời gian theo dõi và tình trạng kiểm duyệt.
Không được mặc định dữ liệu trống bằng 0.
Cần xác định missingness có thể là MCAR, MAR hoặc MNAR và lựa chọn chiến lược xử lý phù hợp, chẳng hạn multiple imputation trong những tình huống thích hợp.
Bước 3. Mô tả dữ liệu
Đối với biến định lượng tương đối đối xứng, có thể trình bày:
Mean ± SD.
Đối với dữ liệu lệch hoặc có ngoại lai, có thể trình bày:
Median (Q1–Q3).
Với biến phân loại:
n (%).
Với dữ liệu sống còn:
Kaplan–Meier estimates, số bệnh nhân có nguy cơ theo thời gian và các thước đo sống còn phù hợp.
Không nên trình bày mean ± SD chỉ vì đó là định dạng quen thuộc.
Bước 4. Vẽ biểu đồ thăm dò
Nên xem xét:
- Histogram: hình dạng phân phối.
- Q–Q plot: so sánh phân vị thực nghiệm với phân phối tham chiếu.
- Boxplot: trung vị, độ phân tán và giá trị ngoại lai.
- Scatterplot: liên hệ giữa hai biến.
- Residual plot: cấu trúc sai số mô hình.
- Kaplan–Meier curve: thời gian đến biến cố.
- Forest plot: các ước lượng hiệu quả và khoảng tin cậy.
Với dữ liệu có nhiều giá trị 0 hoặc nhiều đỉnh, cần mô tả rõ hơn thay vì ép dữ liệu vào một phân phối đơn giản.
Bước 5. Xây dựng mô hình
Ví dụ mục tiêu dự đoán tử vong:
Outcome: Death28.
Predictors: Age, SOFA, Lactate.
Một mô hình logistic khởi đầu:
logit[P(Death28=1)] = β₀ + β₁Age + β₂SOFA + β₃Lactate.
Cần đánh giá:
- Mức độ phù hợp của dạng hàm.
- Quan hệ phi tuyến của biến liên tục.
- Thiếu dữ liệu.
- Đa cộng tuyến.
- Số lượng biến cố so với độ phức tạp mô hình.
- Calibration.
- Discrimination.
- Internal validation.
- Overfitting.
Không nên phân nhóm tuổi, lactate hoặc SOFA bằng một ngưỡng tùy ý chỉ để đơn giản hóa hồi quy.
Bước 6. Báo cáo kết quả
Một bài báo tốt không chỉ báo p-value.
Cần trình bày:
Effect size + 95% confidence interval + p-value, nếu phù hợp + ý nghĩa lâm sàng.
Ví dụ cách viết:
“After adjustment for age, sex, and baseline SOFA score, the exposure was associated with higher odds of 28-day mortality (adjusted OR 1.80; 95% CI 1.20–2.70).”
Đây là câu mô phỏng cách viết báo cáo kết quả, không phải phát hiện từ một nghiên cứu thực tế.
VI. NHỮNG LỖI THỐNG KÊ CÓ THỂ LÀM GIẢM CHẤT LƯỢNG BÀI BÁO
1. Dùng kiểm định không phù hợp với thiết kế
Ví dụ sử dụng independent t-test để so sánh trước–sau cùng bệnh nhân.
2. Nhầm tỷ lệ nguy cơ với odds ratio
OR = 2 không đồng nghĩa nguy cơ tăng gấp đôi, nhất là khi biến cố thường gặp.
3. Nhầm số ca với tỷ suất biến cố
Đơn vị có 20 ca nhiễm khuẩn trong 10.000 ngày điều trị không thể so sánh trực tiếp số ca thô với đơn vị có 15 ca trong 2.000 ngày điều trị.
4. Bỏ qua thời gian theo dõi
Phân tích tử vong 30 ngày không thể tự động thay thế cho phân tích thời gian đến tử vong khi có kiểm duyệt và thời gian theo dõi không đồng đều.
5. Chỉ lựa chọn biến có p < 0,05 trong phân tích đơn biến
Cách làm này có thể bỏ sót yếu tố nhiễu quan trọng, gây bất ổn mô hình và không bảo đảm một mô hình đa biến hợp lý.
Lựa chọn biến cần dựa trên mục tiêu nghiên cứu, kiến thức chuyên môn và chiến lược phân tích được xác định trước.
6. Lạm dụng chia đôi biến liên tục
Chuyển SOFA thành nhóm cao/thấp có thể làm mất thông tin và công suất thống kê.
7. Kiểm định quá nhiều giả thuyết
Kiểm định hàng chục biến mà không có chiến lược kiểm soát sai lầm đa kiểm định có thể làm tăng nguy cơ phát hiện dương tính giả.
8. Nhầm ý nghĩa thống kê với ý nghĩa lâm sàng
Một khác biệt rất nhỏ có thể đạt p < 0,001 trong nghiên cứu lớn nhưng không có ý nghĩa thực tiễn.
Ngược lại, một kết quả có khoảng tin cậy rộng và p > 0,05 không chứng minh rằng hai phương pháp điều trị tương đương.
VII. ĐỀ XUẤT KHUNG PHÂN TÍCH CHO NGHIÊN CỨU HỒI SỨC – CHỐNG ĐỘC
Giả sử thực hiện đề tài:
“Các yếu tố liên quan đến tử vong và thời gian nằm viện ở bệnh nhân ngộ độc cấp điều trị tại đơn vị Hồi sức tích cực.”
Mục tiêu 1. Mô tả đặc điểm bệnh nhân
Biến nghiên cứu:
- Tuổi, giới.
- Loại chất độc.
- SOFA, APACHE II.
- Lactate, creatinine.
- Thời gian nằm viện.
- Các phương thức hỗ trợ tạng.
Phân tích:
- n (%).
- Mean ± SD hoặc Median (IQR).
- Histogram và Q–Q plot cho các biến phù hợp.
Mục tiêu 2. Xác định yếu tố liên quan tử vong
Kết cục: Death28.
Mô hình ứng viên: hồi quy logistic hoặc mô hình ước lượng RR phù hợp.
Kết quả báo cáo: adjusted OR hoặc adjusted RR với 95% CI.
Mục tiêu 3. Đánh giá thời gian đến tử vong
Kết cục: thời gian từ mốc khởi đầu nghiên cứu đến tử vong.
Phân tích:
- Kaplan–Meier.
- Log-rank trong những điều kiện phù hợp.
- Cox regression.
- Weibull hoặc mô hình tham số thích hợp nếu có lý do.
Cần xác định rõ cách xử lý xuất viện, chuyển viện, mất theo dõi và competing risks.
Mục tiêu 4. Phân tích thời gian nằm ICU
Thời gian nằm ICU là một biến dương hoặc không âm, thường có phân phối lệch phải.
Tuy nhiên, thời gian nằm viện chịu ảnh hưởng của tử vong và xuất viện còn sống. Vì vậy không nên chỉ chọn Gamma regression dựa trên hình dạng histogram.
Cần xác định rõ mục tiêu: thời gian nằm ICU trong toàn quần thể, thời gian đến xuất viện còn sống, hay thời gian nằm ICU ở người sống sót. Những mục tiêu này có ý nghĩa khác nhau và có thể cần mô hình competing risks hoặc multistate.
Mục tiêu 5. Phân tích số biến cố
Kết cục: số biến chứng hoặc số lần can thiệp trong khoảng theo dõi.
Phương pháp ứng viên:
- Poisson regression.
- Negative Binomial regression.
- Mô hình có offset nếu thời gian phơi nhiễm không đồng đều.
VIII. MẪU VIẾT PHẦN PHƯƠNG PHÁP THỐNG KÊ TRONG BÀI BÁO QUỐC TẾ
Statistical Analysis – Mẫu tham khảo
“Continuous variables were summarized as means with standard deviations or medians with interquartile ranges, as appropriate. Categorical variables were expressed as frequencies and percentages. Data distributions were assessed using graphical methods, including histograms and Q–Q plots. Between-group comparisons were performed using Welch’s t-test, the Mann–Whitney U test, the chi-square test, or Fisher’s exact test, as appropriate to the variable and study design. Multivariable logistic regression was used to evaluate associations with the binary primary outcome. Time-to-event outcomes were assessed using Kaplan–Meier methods and Cox proportional hazards models, with assessment of the proportional hazards assumption. Count outcomes were analyzed using Poisson or negative binomial regression, as appropriate, with an offset for exposure time when applicable. Effect estimates were reported with 95% confidence intervals. Missing data and model diagnostics were evaluated according to the prespecified statistical analysis plan.”
Dịch nghĩa:
Các biến liên tục được trình bày dưới dạng trung bình và độ lệch chuẩn hoặc trung vị và khoảng tứ phân vị tùy theo đặc điểm dữ liệu. Các biến phân loại được trình bày dưới dạng tần số và tỷ lệ phần trăm. Phân phối dữ liệu được đánh giá bằng các phương pháp đồ họa, bao gồm histogram và Q–Q plot. Việc so sánh giữa các nhóm sử dụng các kiểm định phù hợp với loại biến và thiết kế nghiên cứu. Hồi quy logistic đa biến được sử dụng để đánh giá các yếu tố liên quan đến kết cục nhị phân. Các kết cục thời gian đến biến cố được phân tích bằng phương pháp Kaplan–Meier và mô hình Cox, kèm kiểm tra giả định proportional hazards. Các kết cục số đếm được phân tích bằng Poisson hoặc Negative Binomial khi phù hợp. Các ước lượng hiệu quả được báo cáo cùng khoảng tin cậy 95%. Dữ liệu thiếu và các chẩn đoán mô hình được đánh giá theo kế hoạch phân tích thống kê đã xác định trước.
Lưu ý: đây là đoạn văn mẫu. Chỉ giữ lại những phương pháp thực sự được sử dụng trong nghiên cứu của mình.
IX. 10 NGUYÊN TẮC VÀNG TRONG PHÂN TÍCH SỐ LIỆU Y HỌC
- Bắt đầu từ câu hỏi nghiên cứu và xác định rõ estimand.
- Phân biệt biến nhị phân, biến số đếm, biến liên tục và biến thời gian đến biến cố.
- Khảo sát hình dạng dữ liệu trước khi lựa chọn mô hình.
- Không sử dụng kiểm định tính chuẩn như một công cụ quyết định duy nhất.
- Phân biệt phân phối dữ liệu với phân phối của thống kê kiểm định.
- Xử lý đúng dữ liệu ghép cặp, đo lặp lại và phân cụm.
- Đánh giá tính phù hợp của mô hình và các giả định.
- Báo cáo effect size cùng khoảng tin cậy, không chỉ p-value.
- Thực hiện phân tích độ nhạy khi cần.
- Diễn giải kết quả theo cả ý nghĩa thống kê và ý nghĩa lâm sàng.
X. KẾT LUẬN
Poster “If Distributions Had Personalities” không chỉ là một hình minh họa vui về xác suất thống kê. Đây là cách tiếp cận trực quan giúp người học hiểu rằng mỗi kiểu dữ liệu có cấu trúc toán học và những yêu cầu phân tích khác nhau.
Normal giúp chúng ta hiểu các hiện tượng đối xứng và nhiều nền tảng suy luận thống kê.
Bernoulli và Poisson giúp phân biệt kết cục có/không với số lượng biến cố.
Gamma và Lognormal là những mô hình hữu ích đối với dữ liệu dương, lệch phải.
Student’s t là nền tảng của nhiều phép suy luận về trung bình.
Beta hỗ trợ mô hình hóa độ bất định của xác suất.
Exponential và Weibull giúp mô hình hóa thời gian đến biến cố.
Cauchy nhắc nhở về giới hạn của trung bình và ảnh hưởng của đuôi nặng.
Delta Dirac biểu diễn tình huống một biến ngẫu nhiên tập trung hoàn toàn ở một giá trị.
Bài học quan trọng nhất:
“Good medical research does not begin with a p-value. It begins with a well-defined question, reliable data, and an appropriate statistical model.”
Nghiên cứu Y học tốt không bắt đầu bằng một giá trị p. Nó bắt đầu bằng câu hỏi rõ ràng, dữ liệu đáng tin cậy và mô hình thống kê phù hợp.
Đối với sinh viên Y khoa và bác sĩ nghiên cứu khoa học, hiểu được phân phối xác suất chính là bước đầu tiên để đi từ thu thập số liệu đến tạo ra bằng chứng khoa học có giá trị.
TÀI LIỆU THAM KHẢO
- Weaver LK, Hopkins RO, Chan KJ, et al. Hyperbaric Oxygen for Acute Carbon Monoxide Poisoning. N Engl J Med. 2002;347:1057–1067. https://doi.org/10.1056/NEJMoa013121
- RECOVERY Collaborative Group. Dexamethasone in Hospitalized Patients with Covid-19. N Engl J Med. 2021;384:693–704. https://doi.org/10.1056/NEJMoa2021436
- Semler MW, Self WH, Wanderer JP, et al. Balanced Crystalloids versus Saline in Critically Ill Adults. N Engl J Med. 2018;378:829–839. https://doi.org/10.1056/NEJMoa1711584
- Hébert PC, Wells G, Blajchman MA, et al. A Multicenter, Randomized, Controlled Clinical Trial of Transfusion Requirements in Critical Care. N Engl J Med. 1999;340:409–417. https://doi.org/10.1056/NEJM199902113400601
- Bland JM, Altman DG. Statistics Notes: Transforming Data. BMJ. 1996;312:770. https://doi.org/10.1136/bmj.312.7033.770
- Bland JM, Altman DG. Statistics Notes: Transformations, Means, and Confidence Intervals. BMJ. 1996;312:1079. https://doi.org/10.1136/bmj.312.7038.1079
- Bland JM, Altman DG. Statistics Notes: The Use of Transformation When Comparing Two Means. BMJ. 1996;312:1153. https://doi.org/10.1136/bmj.312.7039.1153
PCC fC | Medical Research Education | 2026
Học đúng bản chất – Phân tích đúng phương pháp – Công bố bằng chứng đáng tin cậy.